
configuração do Ollama para Verity Mod: IA local no Minecraft
Esta configuração do Ollama para Verity Mod explica como ligar uma instalação Java a um modelo no seu computador, como o caminho estável 5.7.4 com LiteLLM difere da versão 6.0.0 e como testar cada serviço antes de alterar arquivos do Minecraft.
Registros de versões do projeto e documentação da CLI do Ollama conferidos em 16 de novembro de 2026. Verity JE 6.0.0 é a versão mais recente listada; o caminho LiteLLM 5.7.4 foi mantido como ramo legado claramente identificado.
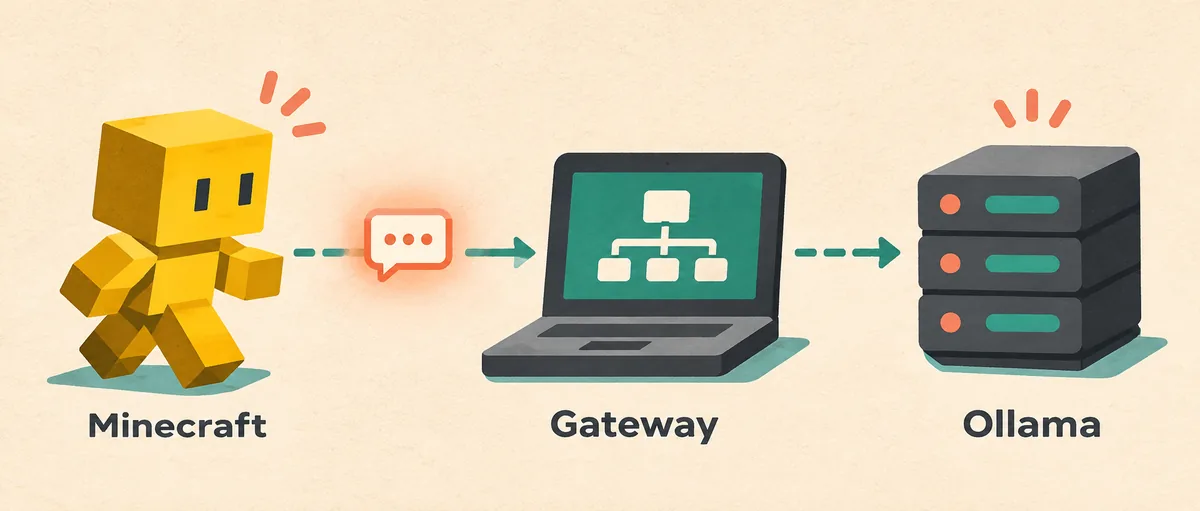
Resposta curta: separe Minecraft, gateway e Ollama
A configuração do Ollama para Verity Mod é uma cadeia de serviços, não um único download. O Minecraft executa o Verity, o Verity envia uma solicitação de conversa ao endereço das configurações de LLM local, um gateway pode traduzir essa solicitação e o Ollama carrega o modelo que escreve a resposta. Quando todas as camadas são testadas ao mesmo tempo, modelo ausente, porta fechada e versão errada do mod parecem o mesmo erro. Teste uma camada por vez para manter cada causa visível e fácil de comparar.
Comece pelo registro atual do projeto Java. O Modrinth lista Verity JE 6.0.0 para Minecraft 1.20.1 e Forge, publicado em 23 de outubro de 2026, com um JAR de 256.881.551 bytes. O changelog diz que o tratamento de IA local mudou; portanto, não cole os campos LiteLLM antigos de 5.7.4 em um perfil 6.0.0 sem ler as configurações da versão instalada. O caminho legado 5.7.4 aparece abaixo apenas para quem continua deliberadamente nessa versão.
Esta página trata de geração de texto local. Ela não promete que reconhecimento de microfone, texto para fala, servidor multijogador ou todo evento de terror funcione offline. Esses caminhos têm permissões, modelos, provedores e exigências de rede próprios. Para voz, consulte o guia de microfone e voz; para travamento ou edição incompatível, use o guia de solução entre edições.
- Minecraft Java Edition, o JAR do Verity e o loader precisam funcionar antes do teste de IA local.
- O Ollama deve estar ativo e conter exatamente a tag de modelo solicitada pelo Verity.
- Um gateway só é necessário quando a versão instalada o documenta; 6.0.0 e 5.7.4 não são intercambiáveis.
- Mantenha chaves de API, endereços de servidor e logs privados fora de capturas de tela e posts públicos.
Verifique primeiro a versão do Java e o hardware
Antes de instalar o Ollama, abra a página de requisitos Java do Verity e anote a versão do Minecraft, o loader, a versão do Verity e as dependências. O registro atual da API do Modrinth é Verity JE 6.0.0, Minecraft 1.20.1 e Forge. O arquivo 5.7.4 continua listado, mas é uma versão histórica com outro fluxo de IA local. Um perfil limpo permite distinguir erro de configuração de IA de erro do loader. Esta verificação faz parte da configuração do Ollama para Verity Mod e define o ramo antes dos modelos serem instalados.
A inferência local divide memória e processamento com o Minecraft. Oito gigabytes de RAM podem bastar para um modelo muito pequeno, mas 16 GB dão mais espaço ao jogo e ao modelo. Uma GPU dedicada pode reduzir o tempo de resposta; somente CPU pode funcionar lentamente ou pausar o jogo durante a geração. Os arquivos dos modelos permanecem no disco após o primeiro download e podem ocupar vários gigabytes. São faixas práticas de planejamento, não uma promessa de desempenho.
Escolha um modelo pequeno no primeiro teste. O objetivo é uma resposta curta, não a personalidade mais inteligente possível. Depois que a cadeia funcionar, mude uma variável de modelo por vez e registre o resultado. Nunca use o tamanho do modelo como motivo para expor o Ollama à internet pública. Um endereço de loopback como 127.0.0.1 mantém o primeiro teste no mesmo computador.
| Verificação | Por que importa | Registre |
|---|---|---|
| Minecraft e Forge | O serviço local não corrige um crash do loader | 1.20.1 e o perfil Forge instalado |
| Versão do Verity | 6.0.0 mudou o tratamento de IA local; 5.7.4 tem gateway legado | Versão e nome do arquivo no Modrinth |
| Memória e GPU | O modelo disputa recursos com o jogo | RAM, GPU, espaço livre e tag do modelo |
| Escopo da rede | Uma ligação remota pode expor um serviço sem autenticação | URL de loopback para o primeiro teste |
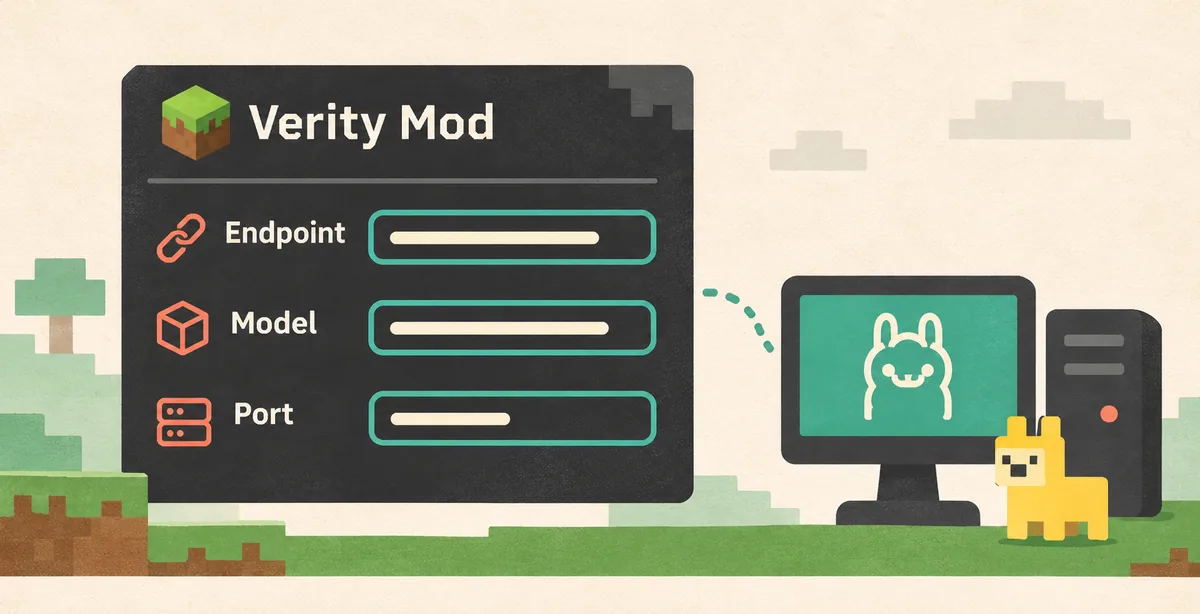
Instale o Ollama e verifique um modelo
Instale o Ollama pela página oficial de download para Windows, macOS ou Linux. Evite instaladores repacotados que prometem incluir um modelo especial do Verity. A referência oficial da CLI documenta `ollama run`; use os comandos compatíveis com a versão instalada em vez de copiar um vídeo sem relação. Reabra o terminal se o comando não for encontrado.
Baixe um modelo pequeno e anote a tag exata exibida por `ollama list`. Uma tag como `qwen2.5:1.5b` é diferente de `qwen2.5`, `qwen3` ou de um nome comunitário. A grafia exata faz parte do contrato de conexão. Execute o modelo diretamente antes de abrir o Minecraft. Se o Ollama não responde ao próprio teste, o Verity não deve ser o primeiro lugar de investigação.
Em uma instalação de desktop, o Ollama pode rodar como aplicativo em segundo plano. Se o serviço não estiver escutando, inicie-o pelo comando documentado da plataforma, normalmente `ollama serve`, em outro terminal. Mantenha esse terminal aberto durante o teste e não inicie uma segunda cópia na mesma porta. Uma resposta no endereço 11434 só prova que algo respondeu; a lista de modelos e uma resposta gerada são verificações mais fortes.
- Instale o Ollama pela página oficial de download.
- Execute `ollama pull MODEL_TAG` e confirme a mesma tag com `ollama list`.
- Execute `ollama run MODEL_TAG` com uma saudação curta e guarde o resultado como referência.
- Se a CLI não conectar, inicie o serviço local e resolva esse erro antes de configurar o Verity.
- Mantenha o listener em loopback no primeiro setup; acesso remoto exige uma análise de segurança separada.
Use o ramo correto de configuração para sua versão do Verity
A versão atual 6.0.0 é a primeira escolha para uma instalação nova, mas o registro oficial apenas informa que o uso de IA local mudou; não oferece um conjunto universal de nomes de campos para toda compilação. Abra a configuração instalada do Verity e leia os rótulos de LLM local ou configurações de IA que realmente existem. Selecione o provedor Ollama documentado, informe a tag exata do modelo, salve e reabra a tela para confirmar os valores. Não deduza uma opção beta a partir de um tutorial de 5.7.4. Na configuração do Ollama para Verity Mod, essa leitura da versão decide se o gateway é necessário.
Quem usa conscientemente a versão estável 5.7.4 deve seguir o caminho legado descrito pelo tutorial do projeto: o Ollama escuta na porta 11434, o LiteLLM escuta na porta de loopback 4000 e o Verity aponta para o caminho compatível com OpenAI do LiteLLM. O nome do modelo no gateway usa o prefixo de provedor `ollama/`, enquanto a lista do próprio Ollama não usa. Essa diferença causa a maioria das mensagens de modelo não encontrado no ramo antigo.
Para o ramo legado, comece com um comando como `litellm --model ollama/MODEL_TAG --api_base http://127.0.0.1:11434 --host 127.0.0.1 --port 4000` e use a URL e o campo de modelo exatos documentados pela configuração 5.7.4 instalada. Trate-o como exemplo preso à versão, não como exigência da 6.0.0. Se a versão atual oferecer endpoint Ollama direto, prefira o caminho documentado e remova o proxy não utilizado do teste.
| Ramo da versão | Caminho do serviço local | Evite |
|---|---|---|
| Verity JE 6.0.0 | Leia os campos de LLM local / IA instalados e use o caminho Ollama documentado | Copiar valores LiteLLM de 5.7.4 para 6.0.0 |
| Verity JE 5.7.4 | Ollama 11434 mais o gateway LiteLLM de loopback documentado em 4000 | Usar uma tag Ollama sem o prefixo de provedor do gateway |
| Qualquer beta ou fork comunitário | Use as notas de versão e rótulos de configuração do próprio projeto | Tratar um tutorial como universal só porque menciona Verity |
Teste uma mensagem antes de adicionar voz ou multijogador
Depois de salvar a configuração, crie um mundo de teste ou use um perfil descartável. Envie uma mensagem curta pelo caminho de texto documentado do Verity. Uma resposta bem-sucedida prova apenas que o caminho de texto funcionou para aquela versão e modelo; não prova voz, TTS, servidor ou um save existente. Mantenha o primeiro prompt simples para comparar latência e erros.
Se a resposta chegar, anote versão, tag do modelo, endpoint, portas, tempo de resposta e se o Ollama usou a GPU. Esse registro vira sua referência conhecida. Teste uma segunda mensagem somente depois da primeira. Só então adicione voz ou mova o perfil para um servidor privado. O guia de instalação Java cobre mod e dependências; esta página cobre a camada de IA local acima deles.
Se o jogo congelar durante a geração, interrompa o teste em vez de pressionar repetidamente o atalho. Reduza o modelo, feche aplicativos concorrentes ou volte ao provedor em nuvem documentado pelo projeto. Um modelo local pode ser privado e ainda ser pesado demais para o mesmo computador executar sem travar.
- Use um mundo novo e uma única solicitação de texto.
- Confira o terminal ou log do serviço Ollama no mesmo horário.
- Registre tag do modelo, endpoint, versão e tempo de resposta.
- Adicione voz, TTS ou multijogador somente depois que a referência de texto for repetível.
Resolva erros de conexão, modelo e desempenho
Conexão recusada normalmente significa que o serviço ou gateway não está escutando no endereço configurado. Confirme primeiro o Ollama e depois o gateway, caso sua versão exija um. Uma porta pode estar aberta enquanto o processo errado a utiliza; compare o listener com o endpoint do Verity. Não resolva um erro local ligando em 0.0.0.0 ou encaminhando uma porta antes de entender o impacto de segurança.
Modelo não encontrado significa que a string solicitada não coincide com a tag instalada ou que o prefixo do provedor no gateway está errado. Copie o valor de `ollama list`, compare caractere por caractere e teste o modelo diretamente. No ramo de gateway 5.7.4, o modelo do proxy pode começar com `ollama/`, enquanto a tag local não começa. Na 6.0.0, use o formato mostrado pela versão instalada.
Um timeout ou resposta muito lenta costuma indicar modelo grande, pressão de memória, carregamento inicial ou loop de proxy. Deixe a primeira solicitação terminar uma vez, confira o log e tente um modelo menor. Feche shaders, navegadores e outros processos de IA. Se o jogo trava antes de enviar a solicitação, volte à lista de Java e dependências; o Ollama não participa de um crash do loader.
Uma resposta vazia após uma solicitação de texto bem-sucedida pertence a uma camada posterior. Confira as configurações de prompt ou conversa do projeto instalado e teste voz separadamente. Não cole chaves, caminhos locais ou logs completos em uma issue pública. Oculte segredos e compartilhe versão, modelo, classe do endpoint e o primeiro erro útil.
| Sintoma | Camada provável | Próxima verificação segura |
|---|---|---|
| Conexão recusada | Ollama ou LiteLLM parado, ou URL errada | Teste o serviço diretamente na porta local documentada |
| Modelo não encontrado | Tag ou prefixo do provedor incompatível | Compare `ollama list` com o campo da versão instalada |
| Resposta muito lenta | Modelo grande ou memória compartilhada com Minecraft | Tente um modelo menor e registre a mudança |
| Crash antes da tela inicial | Forge, dependência ou mod sem relação | Use um perfil Java limpo antes de alterar IA |
| Texto funciona, voz falha | Microfone, reconhecimento de fala ou TTS | Siga o guia de voz separado e preserve a referência de texto |
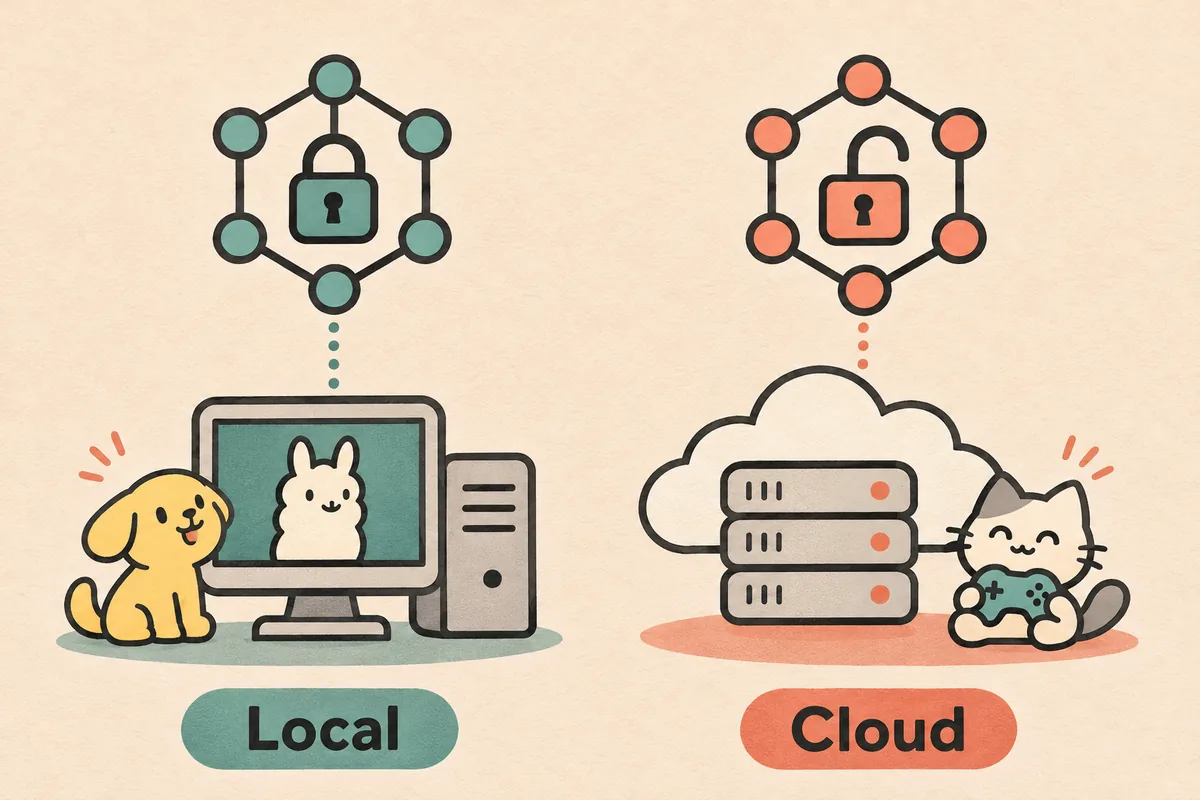
Escolha IA local ou em nuvem com um limite claro
O Ollama é útil quando você quer manter a inferência no computador e tem memória, armazenamento e tempo para administrar modelos. Um provedor em nuvem pode ser mais simples quando a máquina é modesta ou o projeto documenta melhor um caminho hospedado. Nenhuma escolha torna o JAR do Verity oficial, garante segurança ou corrige uma instalação incompatível do Minecraft.
A inferência local pode reduzir a quantidade de conversa enviada a um provedor, mas ainda cria logs locais e pode usar outro serviço para reconhecimento de fala ou TTS. Leia as notas atuais do Verity, os termos do Ollama e a documentação dos provedores antes de ativar recursos. Mantenha o primeiro teste em loopback, faça backup dos mundos e remova arquivos de modelo sem uso.
Quando uma nova versão do Verity muda o caminho de IA local, não migre silenciosamente um perfil que funciona. Copie o perfil, registre os valores antigos, teste a nova versão separadamente e mantenha a versão conhecida até o resultado ser repetível. A lista de segurança de download explica como comparar origem, identidade do arquivo e registro da versão.
- Local: mais controle e potencialmente menos tráfego ao provedor, mas maior custo de hardware e manutenção.
- Nuvem: menos uso de recursos locais, mas pode exigir conta, chave, rede e política do provedor.
- Voz e TTS podem continuar separados do modelo de texto em qualquer escolha.
- Faça backup dos mundos e mantenha um perfil conhecido antes de trocar de versão.
Serviços opcionais Kokoro ou outro TTS
Alguns tutoriais comunitários combinam Ollama com Kokoro ou outro serviço de fala. Trate isso como um segundo projeto opcional, não como parte mínima da configuração do Ollama para Verity Mod. Primeiro prove a geração de texto. Depois instale o serviço de fala pela própria documentação, registre o endpoint e teste-o sem alterar o modelo de texto que funciona. Uma falha de voz não deve levar a downloads aleatórios de JAR.
Versões diferentes podem usar nomes de endpoint, portas ou formatos de áudio diferentes. Verifique a configuração instalada do Verity e as instruções atuais do projeto de fala. Se o texto funcionar e a fala não, relate a camada de áudio separadamente e remova chaves privadas dos logs.
- Referência de texto primeiro; TTS depois.
- Use um processo separado e registre a porta da fala.
- Não trate um vídeo comunitário como garantia oficial de compatibilidade.
Um reset seguro quando a configuração local ficar confusa
Um reset controlado é mais rápido do que mudar todos os valores de uma vez. Copie o perfil e o mundo do Minecraft, pare o Ollama e qualquer gateway, anote versão e modelo e inicie apenas os serviços necessários para aquele ramo. Remova nomes de modelo duplicados da configuração do Verity, restaure a URL de loopback documentada e faça um teste direto do modelo antes de abrir o Minecraft novamente.
Se o perfil limpo funcionar, compare-o com o antigo uma variável por vez. Se falhar do mesmo modo, o problema provavelmente está na versão, modelo, serviço ou endpoint documentado, e não no save. Guarde as evidências e procure o canal de suporte do projeto quando as notas de versão não responderem.
FAQ da configuração do Ollama para Verity Mod
O Verity Mod funciona com Ollama offline?
A geração de texto local pode ocorrer sem enviar essa solicitação a um modelo em nuvem, mas reconhecimento de voz, TTS, atualizações e alguns recursos ainda podem exigir outro serviço. Confira o caminho da versão instalada.
Verity JE 6.0.0 usa a mesma configuração LiteLLM de 5.7.4?
Não presuma isso. O Modrinth descreve um método novo de IA local em 6.0.0. Leia os campos da versão instalada; a porta 4000 é um ramo legado de 5.7.4.
Por que o Ollama diz que o modelo não foi encontrado?
A tag no Verity não coincide exatamente com a instalada no Ollama, ou o prefixo do gateway está errado para essa versão. Compare com `ollama list` e teste diretamente.
Preciso do LiteLLM em toda configuração do Ollama para Verity Mod?
Não. Ele pertence a um caminho legado documentado para algumas versões. Uma versão atual pode conectar diretamente ao Ollama ou usar outros campos. Siga as notas da versão instalada.
Posso usar Ollama em um servidor multijogador do Verity?
Somente quando o projeto Verity escolhido documentar esse arranjo. Faça primeiro um cliente local funcionar e depois compare versões, endpoints e limites no guia multijogador.
Por que o Verity fica lento depois que ativo o Ollama?
Minecraft e o modelo compartilham RAM, GPU e CPU. Tente um modelo menor, feche processos concorrentes, aguarde o primeiro carregamento e compare o tempo com o log local.
O Ollama substitui a configuração de microfone e TTS?
Não. O Ollama cuida da inferência do modelo. Permissões do microfone, reconhecimento de fala e texto para fala continuam sendo camadas separadas.
Uma configuração local do Verity é automaticamente segura?
Não. Use uma origem rastreável, mantenha serviços em loopback durante os testes, proteja chaves, faça backup dos mundos e confira o registro da versão antes de mudar arquivos.
Fontes de versão e configuração
- Versões do Verity JE no Modrinth — Registros atuais, versão do jogo, loader, nomes de arquivo, datas e hashes.
- Metadados de versão do Modrinth — Metadados legíveis por máquina conferidos para os ramos 6.0.0 e 5.7.4.
- Download oficial do Ollama — Use o instalador oficial em vez de um pacote Verity repacotado.
- Referência oficial da CLI do Ollama — Sintaxe da CLI e comandos compatíveis para executar modelos.
- Documentação da CLI do proxy LiteLLM — Referência do comando de gateway legado; use apenas quando a versão instalada exigir um proxy.