
configuration Ollama pour Verity Mod dans Minecraft
Cette configuration Ollama pour Verity Mod explique comment relier une installation Java à un modèle local, distinguer le chemin stable 5.7.4 de la version 6.0.0 et vérifier chaque service avant de modifier Minecraft.
Registri delle release e documentazione CLI di Ollama verificati il 16 novembre 2026. Verity JE 6.0.0 è l'ultima release indicata; il percorso LiteLLM 5.7.4 resta un ramo legacy chiaramente segnalato.
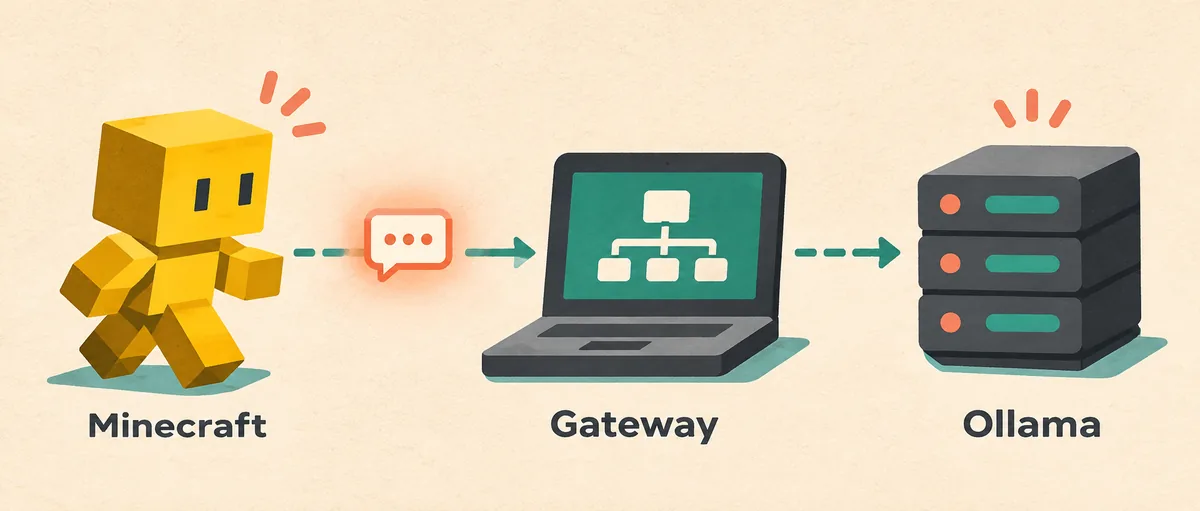
configuration Ollama pour Verity Mod : séparer Minecraft, la passerelle et Ollama
La configurazione Ollama per Verity Mod è una catena di servizi, non un singolo download. Minecraft esegue Verity, Verity invia la chat all'indirizzo nelle impostazioni LLM locali, un gateway può tradurre la richiesta e Ollama carica il modello che produce la risposta. Prova un livello alla volta: modello assente, porta chiusa e versione sbagliata altrimenti sembrano lo stesso errore.
Inizia dal record Java attuale. Modrinth elenca Verity JE 6.0.0 per Minecraft 1.20.1 e Forge, pubblicato il 23 ottobre 2026, con un JAR da 256.881.551 byte. Il changelog indica cambiamenti nella gestione IA locale: non copiare i campi LiteLLM di 5.7.4 in un profilo 6.0.0 senza leggere le impostazioni della release installata. Il ramo 5.7.4 è descritto sotto solo per chi usa deliberatamente quel file.
Questa pagina riguarda la generazione di testo locale. Riconoscimento del microfono, sintesi vocale, server multiplayer e ogni evento horror possono avere percorsi separati, permessi, modelli e requisiti di rete. Per la voce consulta la guida microfono e voce; per crash o incompatibilità usa la guida di troubleshooting tra edizioni.
- Minecraft Java Edition, il JAR Verity e il loader devono funzionare prima di provare l'IA locale.
- Ollama deve essere attivo e contenere il tag esatto richiesto da Verity.
- Un gateway serve solo quando la release installata lo documenta; 6.0.0 e 5.7.4 non sono intercambiabili.
- Tieni chiavi API, indirizzi server e log privati fuori da screenshot e post pubblici.
configuration Ollama pour Verity Mod : vérifier Java et le matériel
Prima di installare Ollama apri la pagina dei requisiti Java di Verity e annota versione Minecraft, loader, release Verity e dipendenze. Il record API attuale di Modrinth è Verity JE 6.0.0, Minecraft 1.20.1 e Forge; 5.7.4 è una release storica con un flusso IA locale diverso. Un profilo pulito separa un errore di configurazione da un errore del loader.
L'inferenza locale condivide memoria e potenza con Minecraft. Otto GB di RAM possono bastare per un modello molto piccolo, mentre 16 GB lasciano più spazio a gioco e modello. Una GPU dedicata riduce spesso i tempi; solo CPU può funzionare lentamente o fermare il gioco durante la generazione. I file dei modelli restano sul disco e possono occupare diversi GB: sono indicazioni pratiche, non garanzie di prestazioni.
Scegli un modello piccolo per il primo test. L'obiettivo è una risposta breve, non la massima qualità del personaggio. Dopo il funzionamento cambia una sola variabile per volta e annota il risultato. Non esporre Ollama a Internet per usare un modello più grande: per il test iniziale usa un indirizzo loopback come 127.0.0.1.
| Controllo | Perché conta | Cosa registrare |
|---|---|---|
| Minecraft e Forge | Il servizio locale non ripara un crash del loader | 1.20.1 e profilo Forge installato |
| Release Verity | 6.0.0 cambia la gestione IA; 5.7.4 ha un gateway legacy | Versione e nome file da Modrinth |
| Memoria e GPU | Il modello compete con il gioco per le risorse | RAM, GPU, spazio libero e tag modello |
| Ambito rete | Un binding remoto può esporre un servizio senza autenticazione | URL loopback per il primo test |
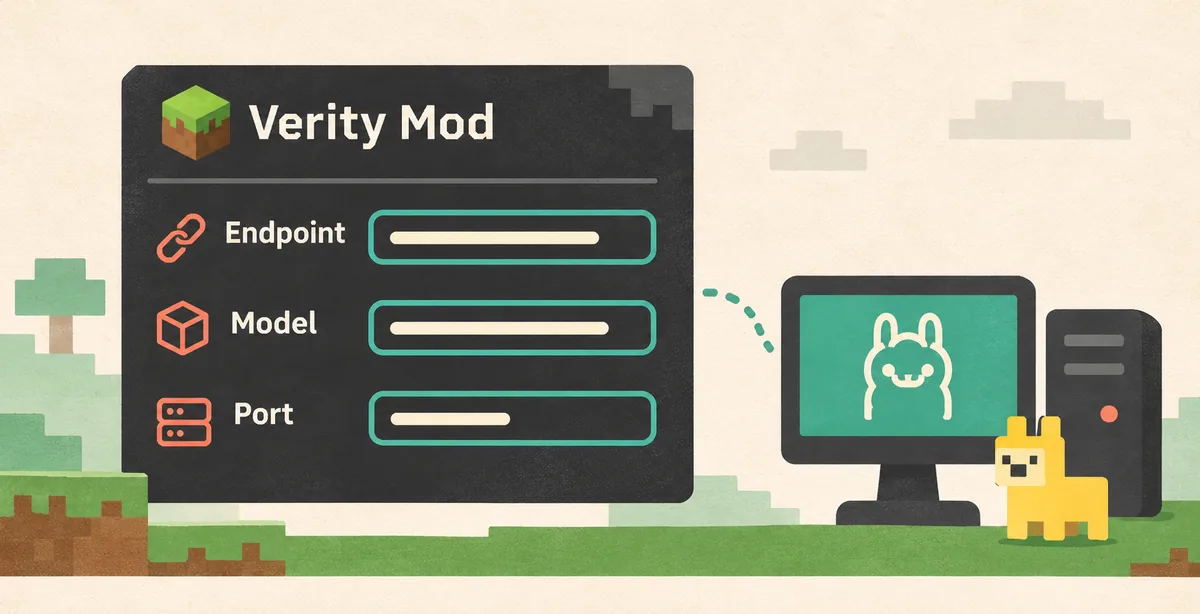
configuration Ollama pour Verity Mod : installer Ollama et vérifier un modèle
Installa Ollama dalla pagina ufficiale per Windows, macOS o Linux. Evita installer ricompressi che promettono un modello Verity speciale. La guida CLI ufficiale documenta `ollama run`: usa la sintassi della versione installata, non un comando preso da un video estraneo. Riavvia il terminale se il comando non viene trovato.
Scarica un modello piccolo e annota il tag esatto mostrato da `ollama list`. `qwen2.5:1.5b` è diverso da `qwen2.5`, `qwen3` o da un nome della community. La grafia è parte del contratto di connessione. Esegui il modello direttamente prima di aprire Minecraft; se Ollama non risponde da solo, Verity non può essere il primo punto di debug.
Su desktop Ollama può funzionare come applicazione in background. Se non ascolta, avvia il servizio con il comando documentato dalla piattaforma, spesso `ollama serve`, in un terminale separato. Lascialo aperto e non avviare una seconda copia sulla stessa porta. Una risposta HTTP sulla 11434 prova solo che qualcosa risponde; elenco modelli e risposta generata sono verifiche migliori.
- Installa Ollama dalla pagina ufficiale.
- Esegui `ollama pull MODEL_TAG`, poi conferma lo stesso tag con `ollama list`.
- Esegui `ollama run MODEL_TAG` con un saluto breve e conserva il risultato come riferimento.
- Se la CLI non si connette, avvia il servizio locale e risolvi l'errore prima di configurare Verity.
- Mantieni il listener sul loopback per il primo test; l'accesso remoto richiede una revisione di sicurezza separata.
configuration Ollama pour Verity Mod : choisir la branche de version
La release 6.0.0 è la scelta iniziale per una nuova installazione, ma il record ufficiale dice soltanto che l'uso IA locale è cambiato. Apri la configurazione di Verity e leggi le etichette Local LLM o AI Settings realmente presenti. Seleziona il provider Ollama documentato, inserisci il tag esatto, salva e riapri la schermata per confermare i valori. Non dedurre un'impostazione beta da un tutorial 5.7.4.
Chi usa volontariamente 5.7.4 può seguire il percorso legacy riportato dal tutorial del progetto: Ollama sulla porta 11434, LiteLLM sul loopback 4000 e Verity sull'endpoint compatibile OpenAI di LiteLLM. Nel gateway il nome modello usa il prefisso `ollama/`, mentre l'elenco locale di Ollama no. Questa differenza causa molti errori model-not-found nel ramo vecchio.
Per il ramo legacy puoi partire da un comando come `litellm --model ollama/MODEL_TAG --api_base http://127.0.0.1:11434 --host 127.0.0.1 --port 4000`, poi usa URL e campo modello indicati dalla configurazione 5.7.4 installata. È un esempio legato alla versione, non una conferma che 6.0.0 richieda LiteLLM. Se la release attuale offre un endpoint Ollama diretto, preferisci quel percorso e rimuovi il proxy dal test.
| Ramo release | Percorso locale | Cosa evitare |
|---|---|---|
| Verity JE 6.0.0 | Leggi i campi Local LLM / AI Settings installati e usa il percorso Ollama documentato | Copiare valori LiteLLM 5.7.4 in 6.0.0 |
| Verity JE 5.7.4 | Ollama 11434 più gateway LiteLLM loopback documentato sulla 4000 | Usare un tag Ollama senza prefisso provider |
| Beta o fork community | Segui note di release e label della configurazione del progetto | Considerare universale un tutorial che cita Verity |
configuration Ollama pour Verity Mod : tester un message avant la voix et le multijoueur
Dopo il salvataggio crea un mondo di prova o un profilo usa-e-getta. Invia un messaggio breve tramite l'interazione testuale documentata da Verity. Una risposta riuscita prova solo il percorso testo per quella release e quel modello; non prova riconoscimento vocale, TTS, server o salvataggi esistenti. Un prompt semplice rende confrontabili latenza ed errori.
Se arriva la risposta, annota release, tag, endpoint, porte, tempo e uso GPU. Questo diventa il riferimento funzionante. Prova un secondo messaggio solo dopo il primo. Poi aggiungi voce o sposta il profilo su un server privato. La guida installazione Java copre mod e dipendenze; qui verifichi il livello IA locale.
Se il gioco si blocca durante la generazione, interrompi il test e non premere ripetutamente il keybind. Riduci il modello, chiudi applicazioni concorrenti o torna al provider cloud documentato dal progetto. Un modello locale può essere privato e comunque troppo pesante per quel computer.
- Usa un mondo pulito e una sola richiesta testuale.
- Controlla il log di Ollama allo stesso orario della richiesta.
- Registra tag, endpoint, release e tempo di risposta.
- Aggiungi voce, TTS o multiplayer solo quando il testo è ripetibile.
configuration Ollama pour Verity Mod : résoudre connexion, modèle et performances
Connection refused di solito indica che servizio o gateway non ascoltano sull'indirizzo configurato. Conferma prima Ollama, poi il gateway se richiesto dalla release. Una porta può essere aperta ma occupata dal processo sbagliato: confronta il listener con l'endpoint di Verity. Non risolvere un errore locale usando 0.0.0.0 o port forwarding senza valutare la sicurezza.
Model not found significa che la stringa non coincide con il tag installato o che il prefisso provider è errato. Copia il valore da `ollama list`, confrontalo carattere per carattere e prova il modello direttamente. Nel ramo 5.7.4 il proxy può richiedere `ollama/`; per 6.0.0 usa il formato mostrato dalla release installata.
Timeout o risposta lenta indicano spesso modello grande, pressione sulla memoria, caricamento a freddo o loop del proxy. Lascia terminare una prima richiesta, controlla il log e prova un modello più piccolo. Chiudi shader, browser e altri processi IA. Se il crash avviene prima dell'invio, torna alla checklist Java e dipendenze: Ollama non partecipa al crash del loader.
Una risposta vuota dopo un testo riuscito appartiene a un livello successivo. Controlla prompt o conversazione del progetto e prova la voce separatamente. Non pubblicare chiavi, percorsi locali o log completi: oscura i segreti e condividi release, modello, classe endpoint e primo errore utile.
| Sintomo | Livello probabile | Controllo successivo |
|---|---|---|
| Connection refused | Ollama o LiteLLM fermo, oppure URL errato | Testa il servizio sulla porta locale documentata |
| Model not found | Tag o prefisso provider non coincidono | Confronta `ollama list` con il campo della release |
| Risposta molto lenta | Modello grande o RAM condivisa con Minecraft | Prova un modello più piccolo e annota il cambio |
| Crash prima del titolo | Forge, dipendenza o mod estranea | Usa un profilo Java pulito prima dell'IA |
| Testo funziona, voce no | Microfono, riconoscimento o TTS | Segui la guida voce mantenendo il riferimento testo |
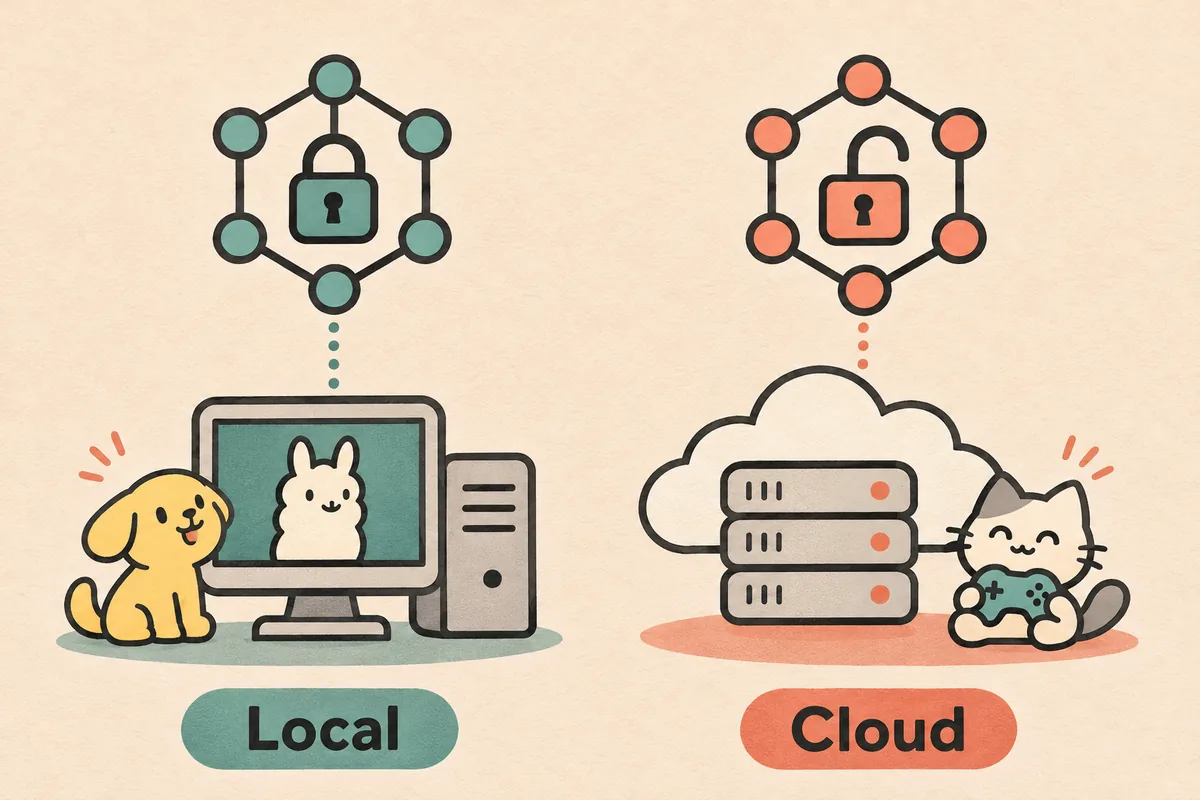
configuration Ollama pour Verity Mod : choisir local ou cloud clairement
Ollama è utile se vuoi mantenere l'inferenza sul computer e hai memoria, spazio e tempo per gestire i modelli. Un provider cloud è più semplice con hardware modesto o quando il progetto documenta meglio il percorso ospitato. Nessuna scelta rende ufficiale il JAR di Verity, garantisce sicurezza o ripara un'installazione Minecraft incompatibile.
L'inferenza locale può ridurre i dati inviati a un provider, ma crea log locali e può usare un servizio diverso per riconoscimento vocale o TTS. Leggi note Verity, condizioni Ollama e documentazione del provider prima di attivare funzioni. Mantieni il primo test sul loopback, fai backup dei mondi e rimuovi modelli inutilizzati.
Quando una nuova release cambia il percorso IA, non migrare in silenzio un profilo funzionante. Copialo, registra i vecchi valori, prova la nuova release separatamente e conserva la versione nota finché il risultato è ripetibile. La checklist sicurezza download spiega come confrontare fonte, identità del file e record della release.
- Locale: più controllo e potenzialmente meno traffico al provider, ma più hardware e manutenzione.
- Cloud: meno risorse locali, ma possono servire account, chiave, rete e policy del provider.
- Voce e TTS possono restare separati dal modello testo in entrambi i casi.
- Fai backup dei mondi e conserva un profilo noto prima di cambiare release.
configuration Ollama pour Verity Mod : services Kokoro ou TTS facultatifs
Alcuni tutorial community combinano Ollama con Kokoro o un altro servizio vocale. Consideralo un secondo progetto opzionale, non parte minima della configurazione Ollama per Verity Mod. Dimostra prima il testo, poi installa il servizio voce dalla sua documentazione, registra endpoint e prova l'audio senza cambiare il modello funzionante. Un errore vocale non deve spingerti verso JAR casuali.
Release diverse possono usare endpoint, porte o formati audio differenti. Verifica la configurazione Verity installata e le istruzioni aggiornate del progetto vocale. Se il testo funziona ma la voce no, segnala separatamente il livello audio e rimuovi le chiavi private dai log.
- Prima il riferimento testo; poi il TTS.
- Registra processo e porta separati per l'audio.
- Un video community non è una garanzia ufficiale di compatibilità.
configuration Ollama pour Verity Mod : réinitialisation sûre
Un reset controllato è più rapido che cambiare ogni valore insieme. Copia profilo e mondo, arresta Ollama e gateway, annota release e modello, poi avvia solo i servizi necessari a quel ramo. Elimina nomi duplicati nel file Verity, ripristina l'URL loopback documentato ed esegui un test diretto prima di riaprire Minecraft.
Se il profilo pulito funziona, confrontalo con quello vecchio una variabile alla volta. Se fallisce allo stesso modo, la causa probabile è release, modello, servizio o endpoint documentato, non il salvataggio. Conserva le prove e usa il canale di supporto del progetto quando le note di release non rispondono.
FAQ de la configuration Ollama pour Verity Mod
Verity Mod funziona offline con Ollama?
La generazione testuale locale può evitare un modello cloud, ma riconoscimento vocale, TTS, aggiornamenti e altre funzioni possono richiedere servizi separati. Controlla il percorso della release installata.
Verity JE 6.0.0 usa lo stesso LiteLLM di 5.7.4?
Non darlo per scontato. Modrinth descrive un nuovo metodo IA locale in 6.0.0. Leggi i campi installati; la porta 4000 è un esempio legacy di 5.7.4.
Perché Ollama dice che il modello non esiste?
Il tag in Verity non coincide esattamente con quello installato oppure il prefisso gateway è errato. Confronta il valore con `ollama list` e provalo direttamente.
Serve LiteLLM per ogni configurazione Ollama per Verity Mod?
No. Appartiene a un percorso legacy documentato per alcune release. Una release corrente può collegarsi direttamente a Ollama o usare campi diversi.
Posso usare Ollama su un server multiplayer Verity?
Solo se il progetto documenta quella disposizione. Fai funzionare prima un client locale, poi confronta release, endpoint e limiti di risorse nel percorso multiplayer.
Perché Verity rallenta dopo aver attivato Ollama?
Minecraft e modello condividono RAM, GPU e CPU. Prova un modello più piccolo, chiudi processi concorrenti, attendi il primo caricamento e confronta i tempi con il log.
Ollama sostituisce microfono e TTS?
No. Ollama gestisce l'inferenza del modello. Permessi del microfono, riconoscimento vocale e sintesi restano livelli separati con impostazioni e servizi propri.
Una configurazione Verity locale è automaticamente sicura?
No. Usa una fonte tracciabile, mantieni i servizi sul loopback durante il test, proteggi le chiavi, fai backup dei mondi e verifica il record della release prima di cambiare file.
Sources de la configuration Ollama pour Verity Mod
- Versioni Verity JE su Modrinth — Release correnti, versione gioco, loader, nomi file, date e hash.
- Metadati versione Modrinth — Metadati leggibili dalle macchine verificati per i rami 6.0.0 e 5.7.4.
- Download ufficiale Ollama — Usa l'installer ufficiale invece di un pacchetto Verity ricomposto.
- Riferimento CLI ufficiale Ollama — Sintassi CLI e comandi supportati per eseguire modelli.
- Documentazione CLI proxy LiteLLM — Riferimento per il comando gateway legacy; usalo solo quando la release installata richiede un proxy.